Разбор типовых ситуаций
Ниже — вопросы, на которые мониторинг отвечает быстрее, чем чтение логов и кода. Все случаи — из практики команды Axiom JDK, описанной в статье о плагине.
Из какой директории запущено приложение
Кажется, что ответ очевиден: из какой директории запустили, такая и рабочая. Локально, особенно при запуске из IDE, это не всегда так.
В одномодульном Maven-проекте рабочей директорией будет директория с pom.xml. В многомодульном при запуске тестов Maven поднимает два процесса:
- общий процесс Maven — в директории родительского модуля;
- процесс, выполняющий unit-тесты конкретного модуля, — в директории
pom.xmlэтого модуля.
Это можно выяснять по документации и логам, а можно открыть свойства процесса и посмотреть фактическое значение свойства user.dir.
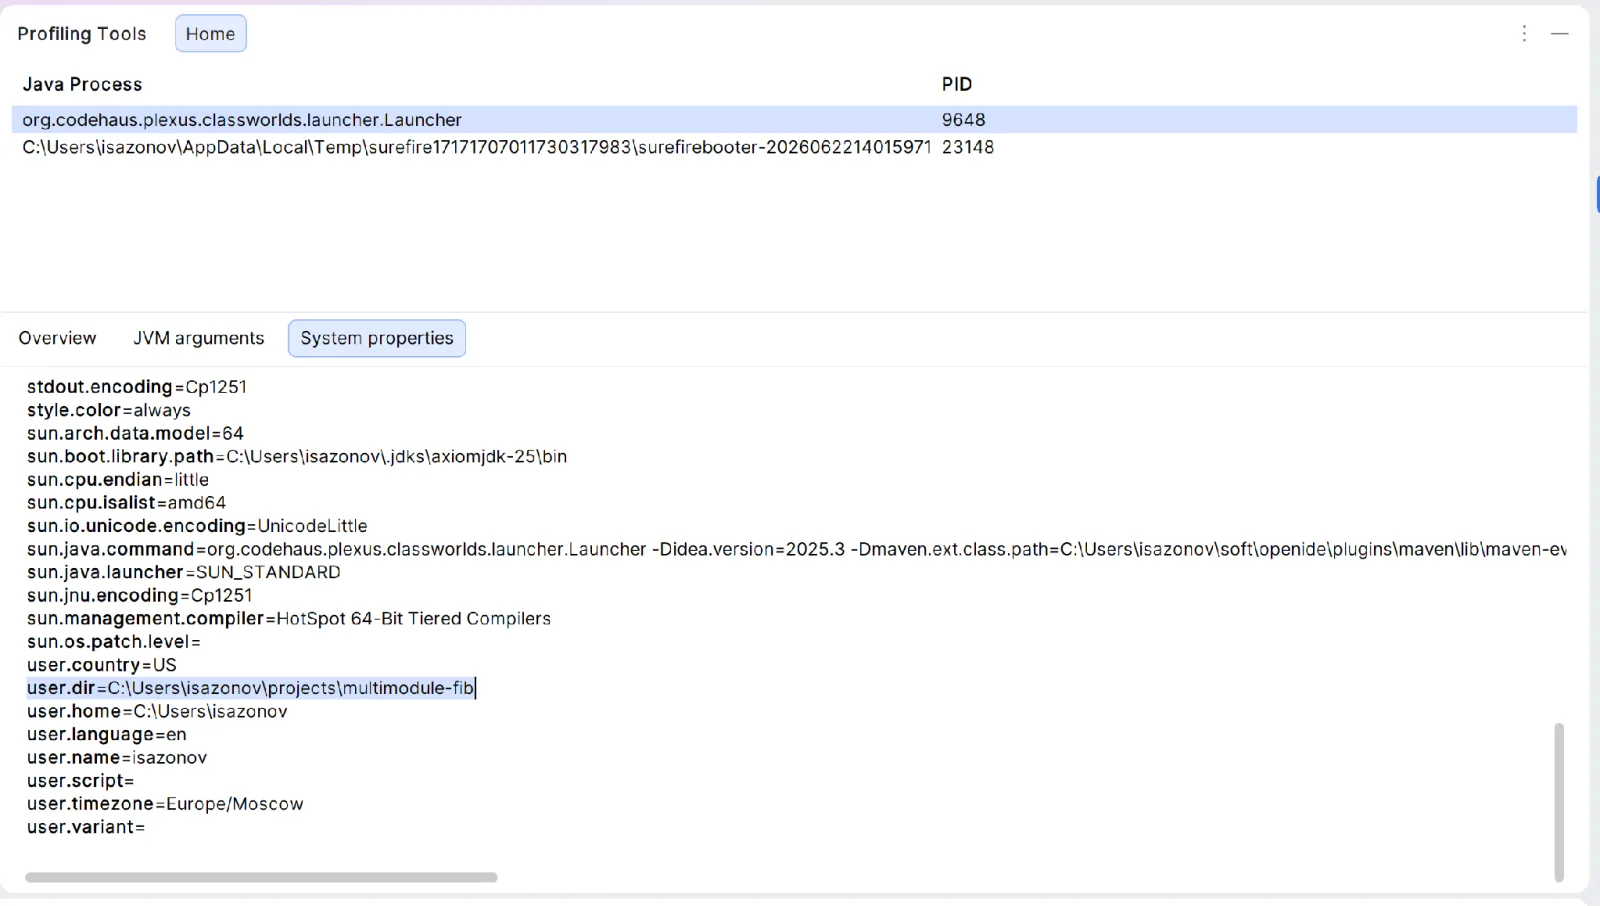
Общий процесс Maven: рабочая директория — корень многомодульного проекта.
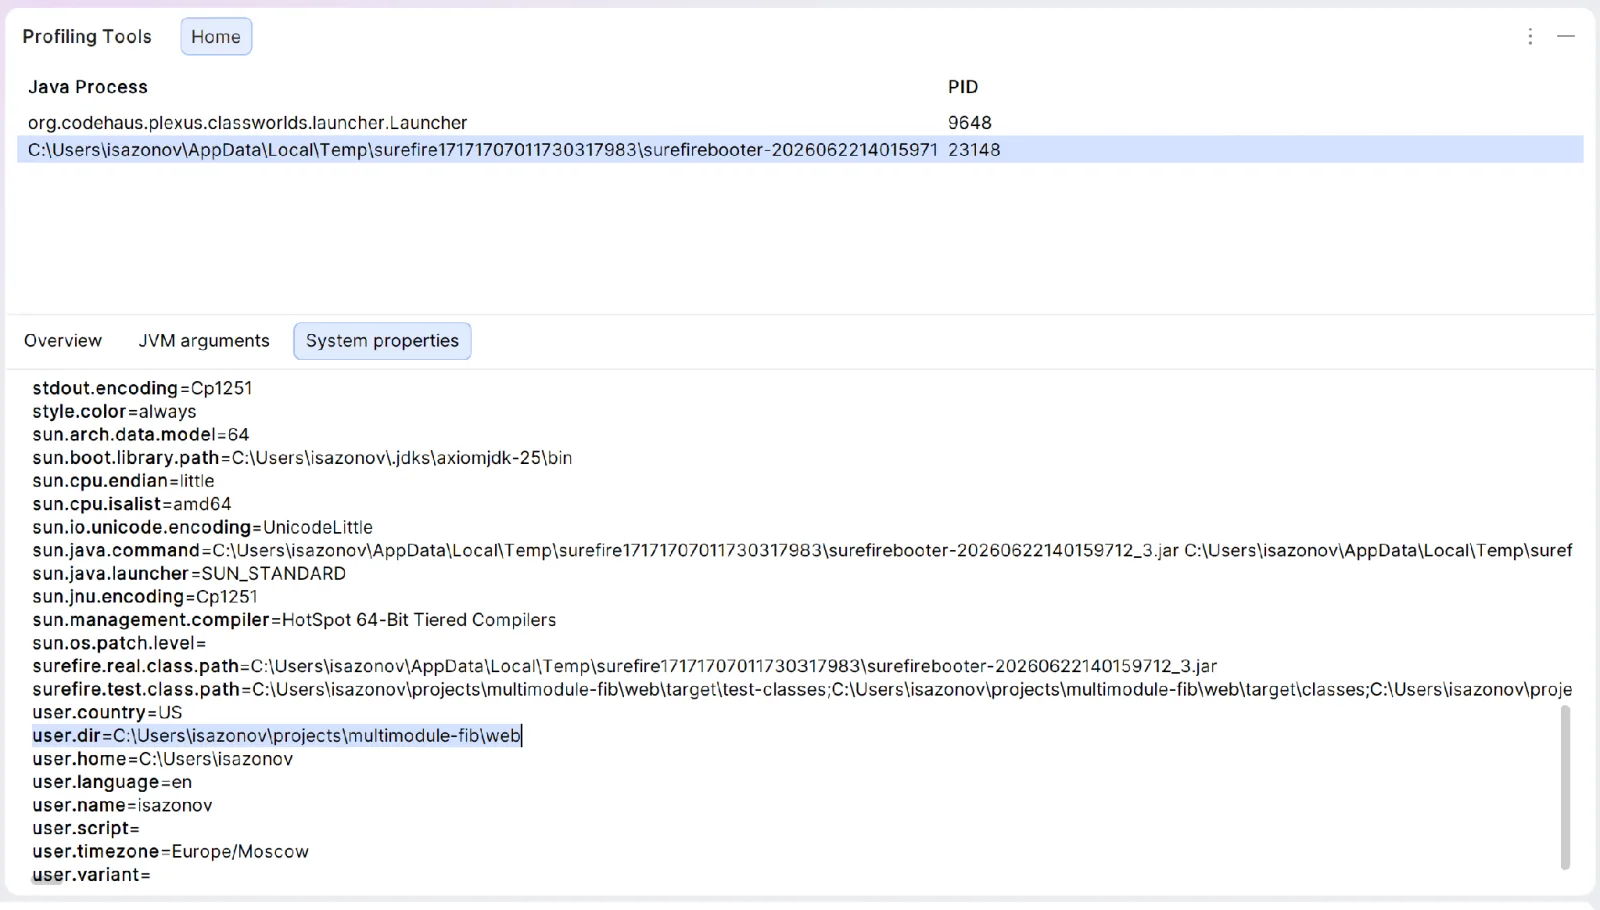
Процесс с unit-тестами: рабочая директория — каталог модуля.
Процессор нагружен, но не Java-приложением
Сервис работает медленно, в коде ничего подозрительного. На графике CPU две кривые, и различие между ними — уже диагноз: если Total поднялся до 40%, а линия JVM около нуля, процессор занят соседним процессом, а Java-сервис просто конкурирует с ним за ресурсы.
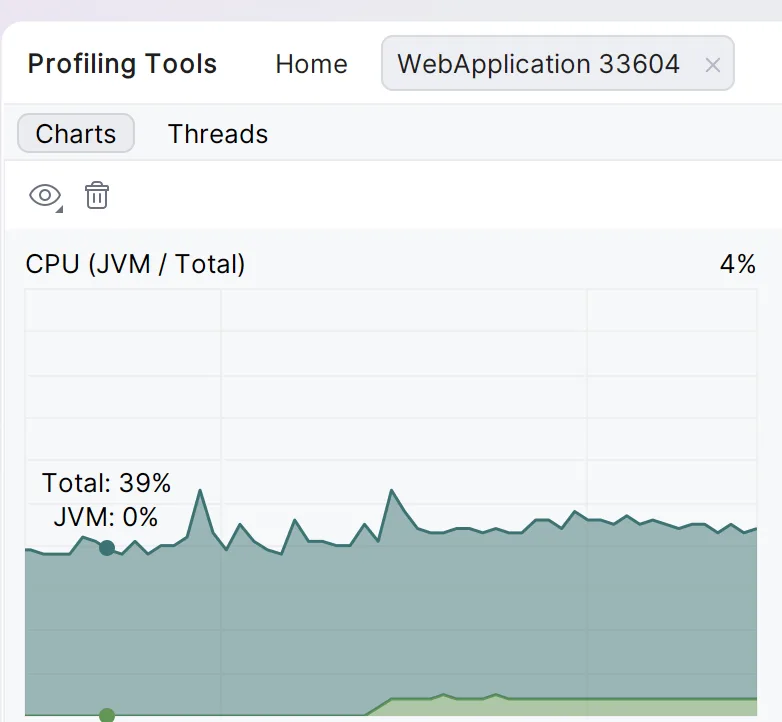
Процессор занят на 39%, Java-приложение к этому почти не причастно.
В примере из статьи это был Python-процесс распознавания речи: часть работы, которая раньше шла на GPU, стала выполняться на CPU и после распараллеливания начала стабильно забирать процессорное время.
По одной метрике такое не ловится. Если смотреть только на JVM, кажется, что приложение ничего не делает. Если только на общий CPU — виноватым выглядит Java-процесс. Вместе они показывают, где искать.
Приложение работает или просто ждёт
Нагрузочный скрипт должен слать 30 запросов в минуту, а за минуту прошло четыре. Похоже, что сервис слишком долго обрабатывает запросы.
Порядок проверки:
- Посмотреть график CPU. Если процессор почти не загружен, приложение вряд ли занято вычислениями.
- Проверить, не потерялась ли нагрузка на одно ядро среди многих. Для этого посмотреть потоки Tomcat: если сервис действительно работает, среди
http-nio-*-exec-*должен быть поток в состоянииRUNNABLE. - Если все exec-потоки в
WAITING, приложение не нагружено и «обрабатывать запрос так долго» не может.
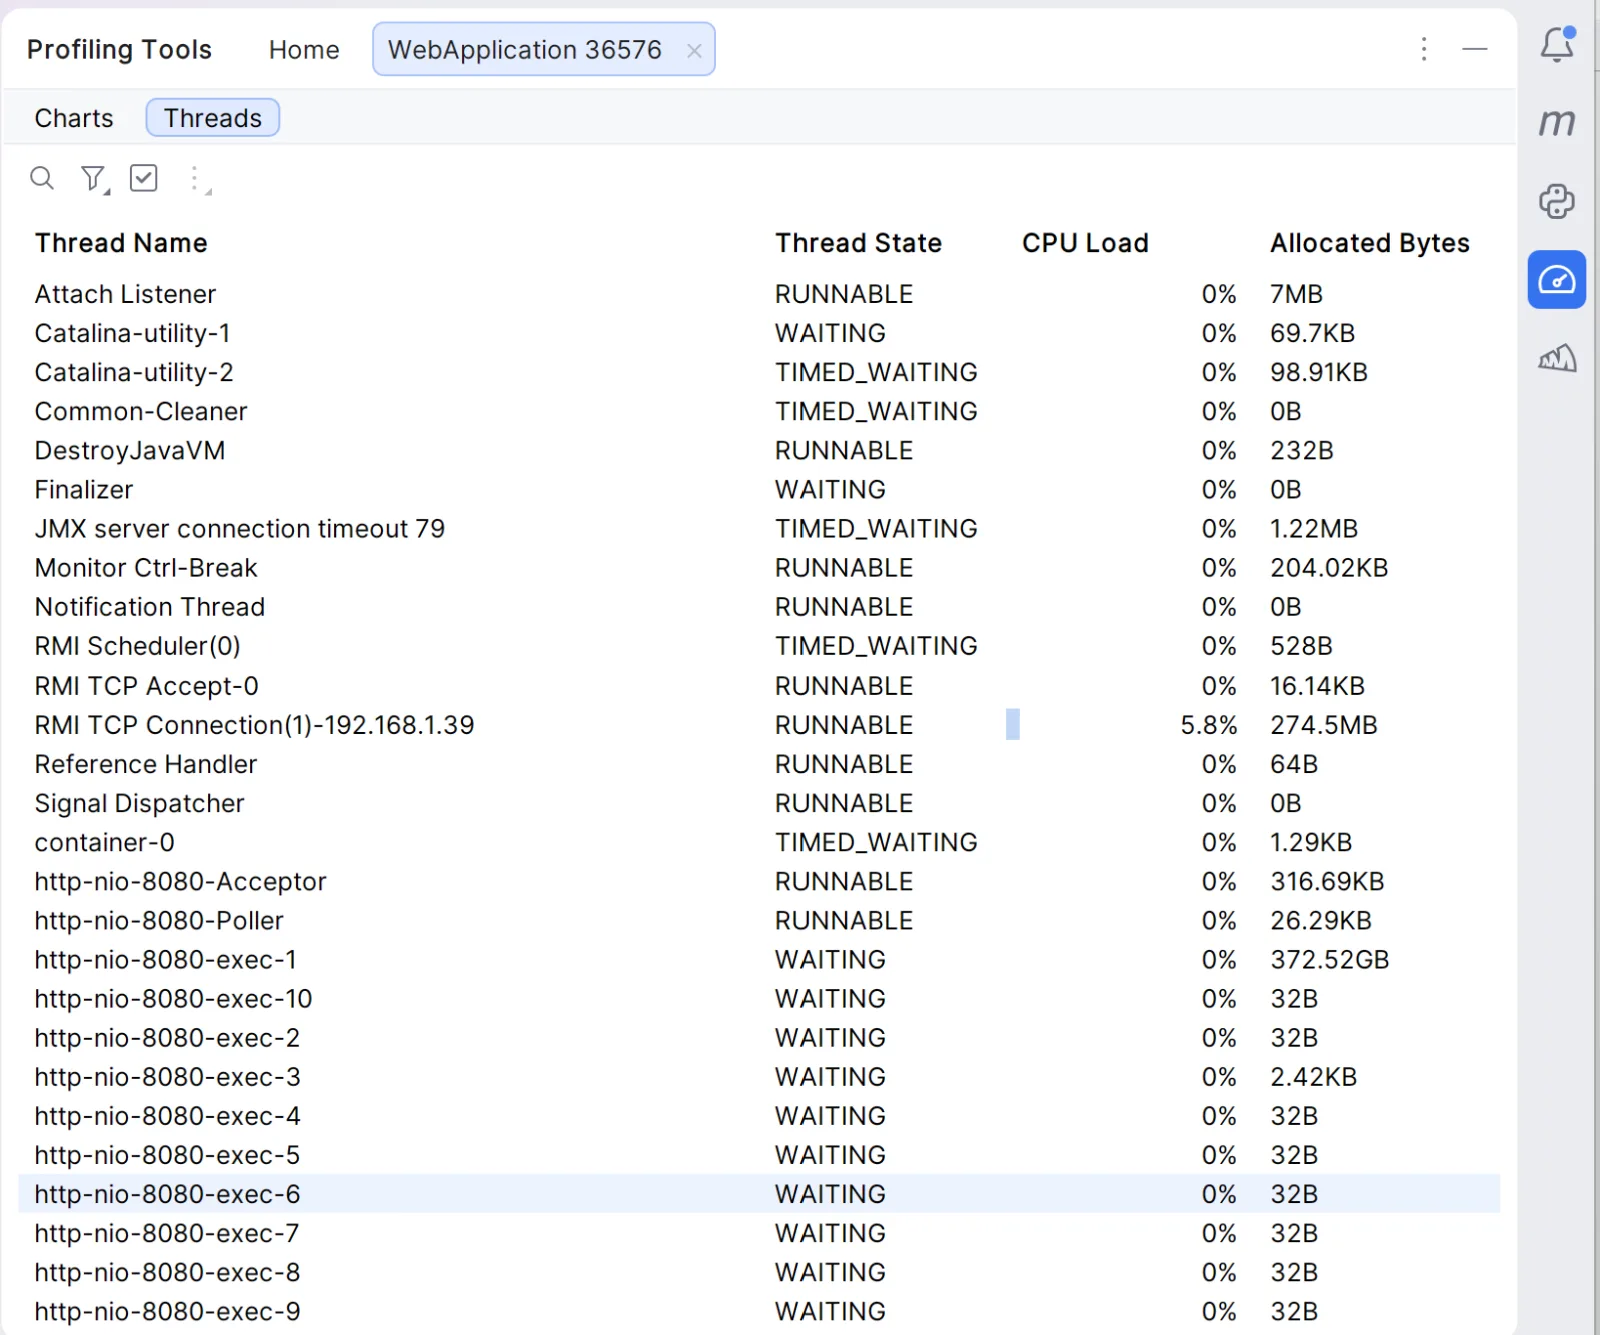
Все обработчики ждут. Нагрузки на приложении нет.
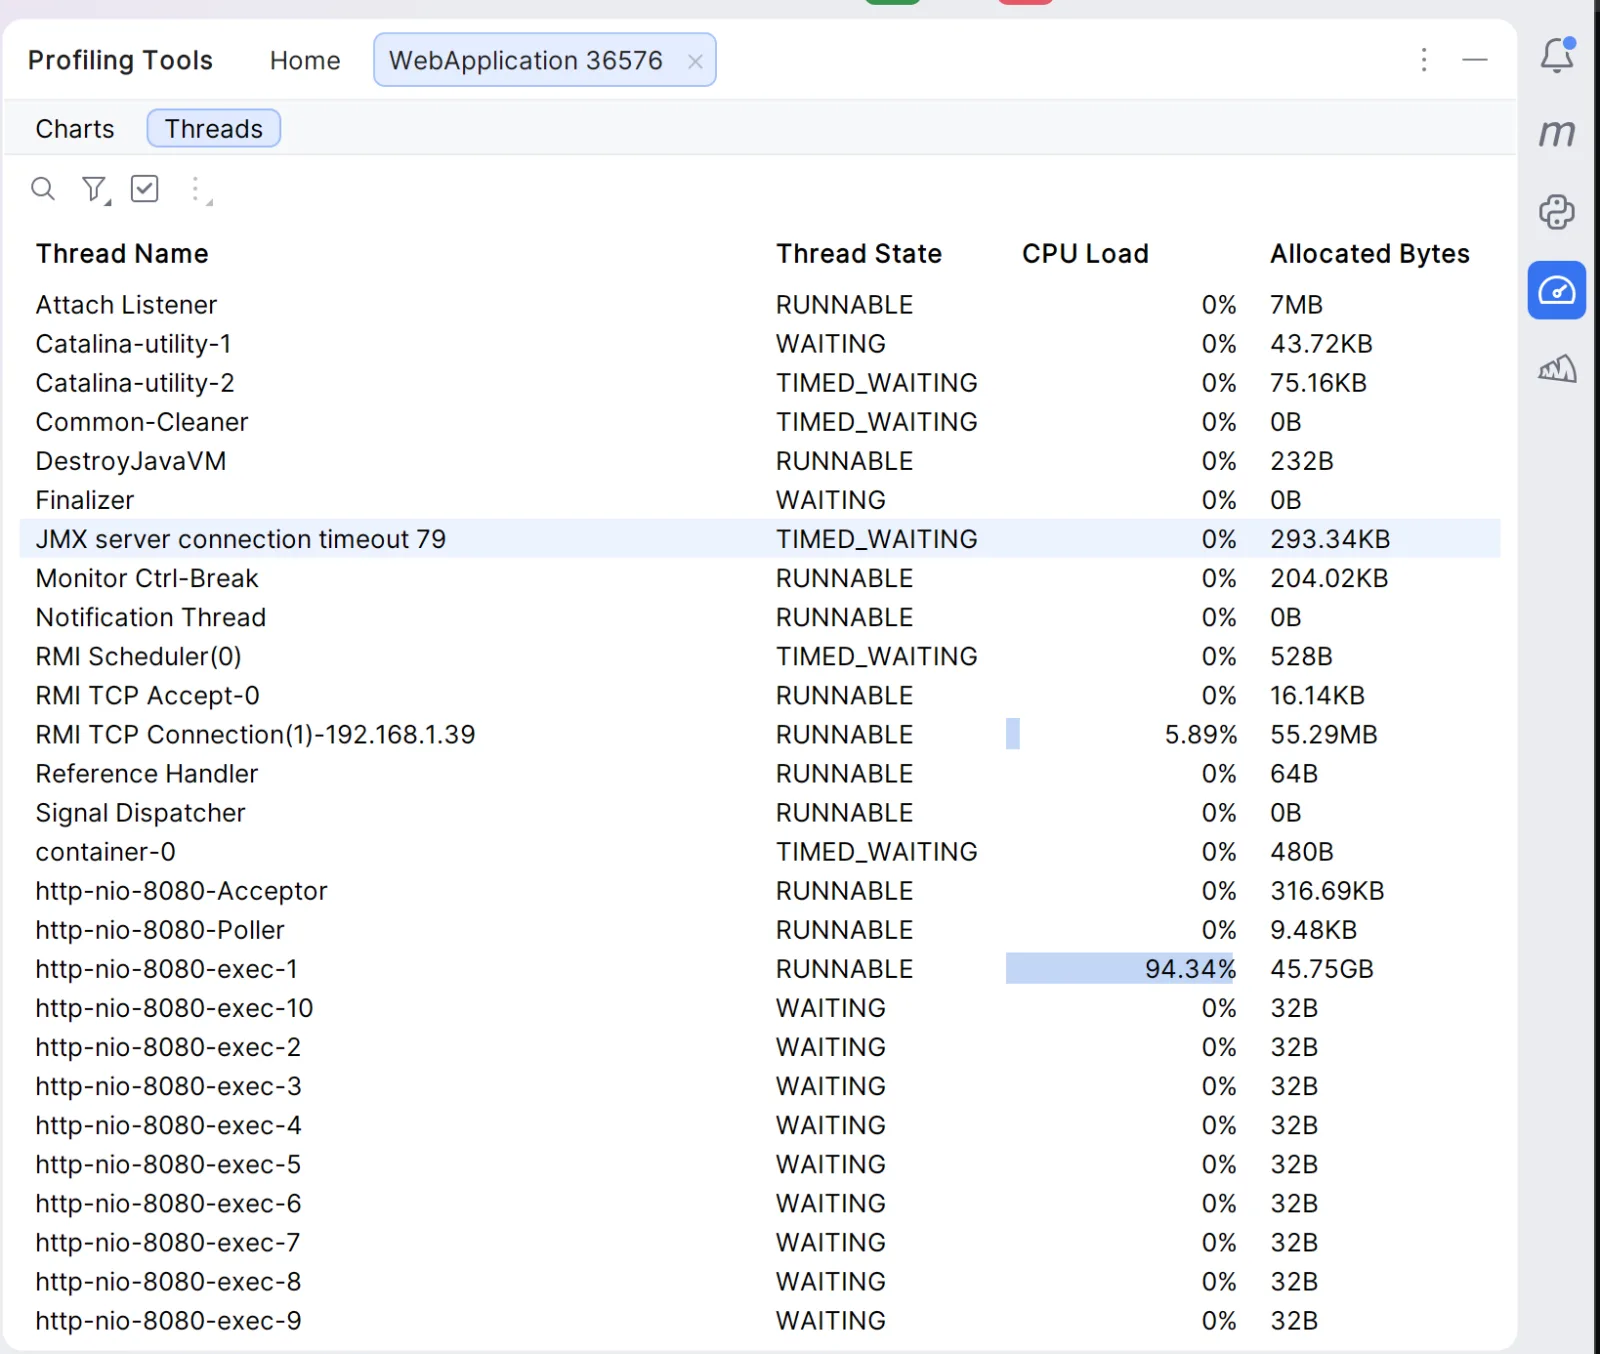
Для сравнения: так выглядит список, когда запрос действительно обрабатывается.
Ручной запрос выполнился за миллисекунды. Виноват был сам нагрузочный скрипт: сгенерированный ИИ bash ненадёжно измерял время, и между запросами проходило не две секунды, а двадцать или две минуты. Правило общее: если приложение «не справляется с нагрузкой», сначала убедитесь, что нагрузка до него доходит.
Поток ждёт задачу или ответ сервиса
Состояние WAITING само по себе не значит, что приложение ничего не делает: обработчик может ждать ответ соседнего сервиса или базы. С точки зрения бизнес-логики запрос выполняется, с точки зрения JVM поток ждёт. Различить помогает стектрейс.
В примере метод контроллера посреди работы вызывает через RestClient внешний сервис, который отвечает с задержкой, — поток обработчика большую часть времени проводит в WAITING, хотя запрос пользователя ещё не завершён.
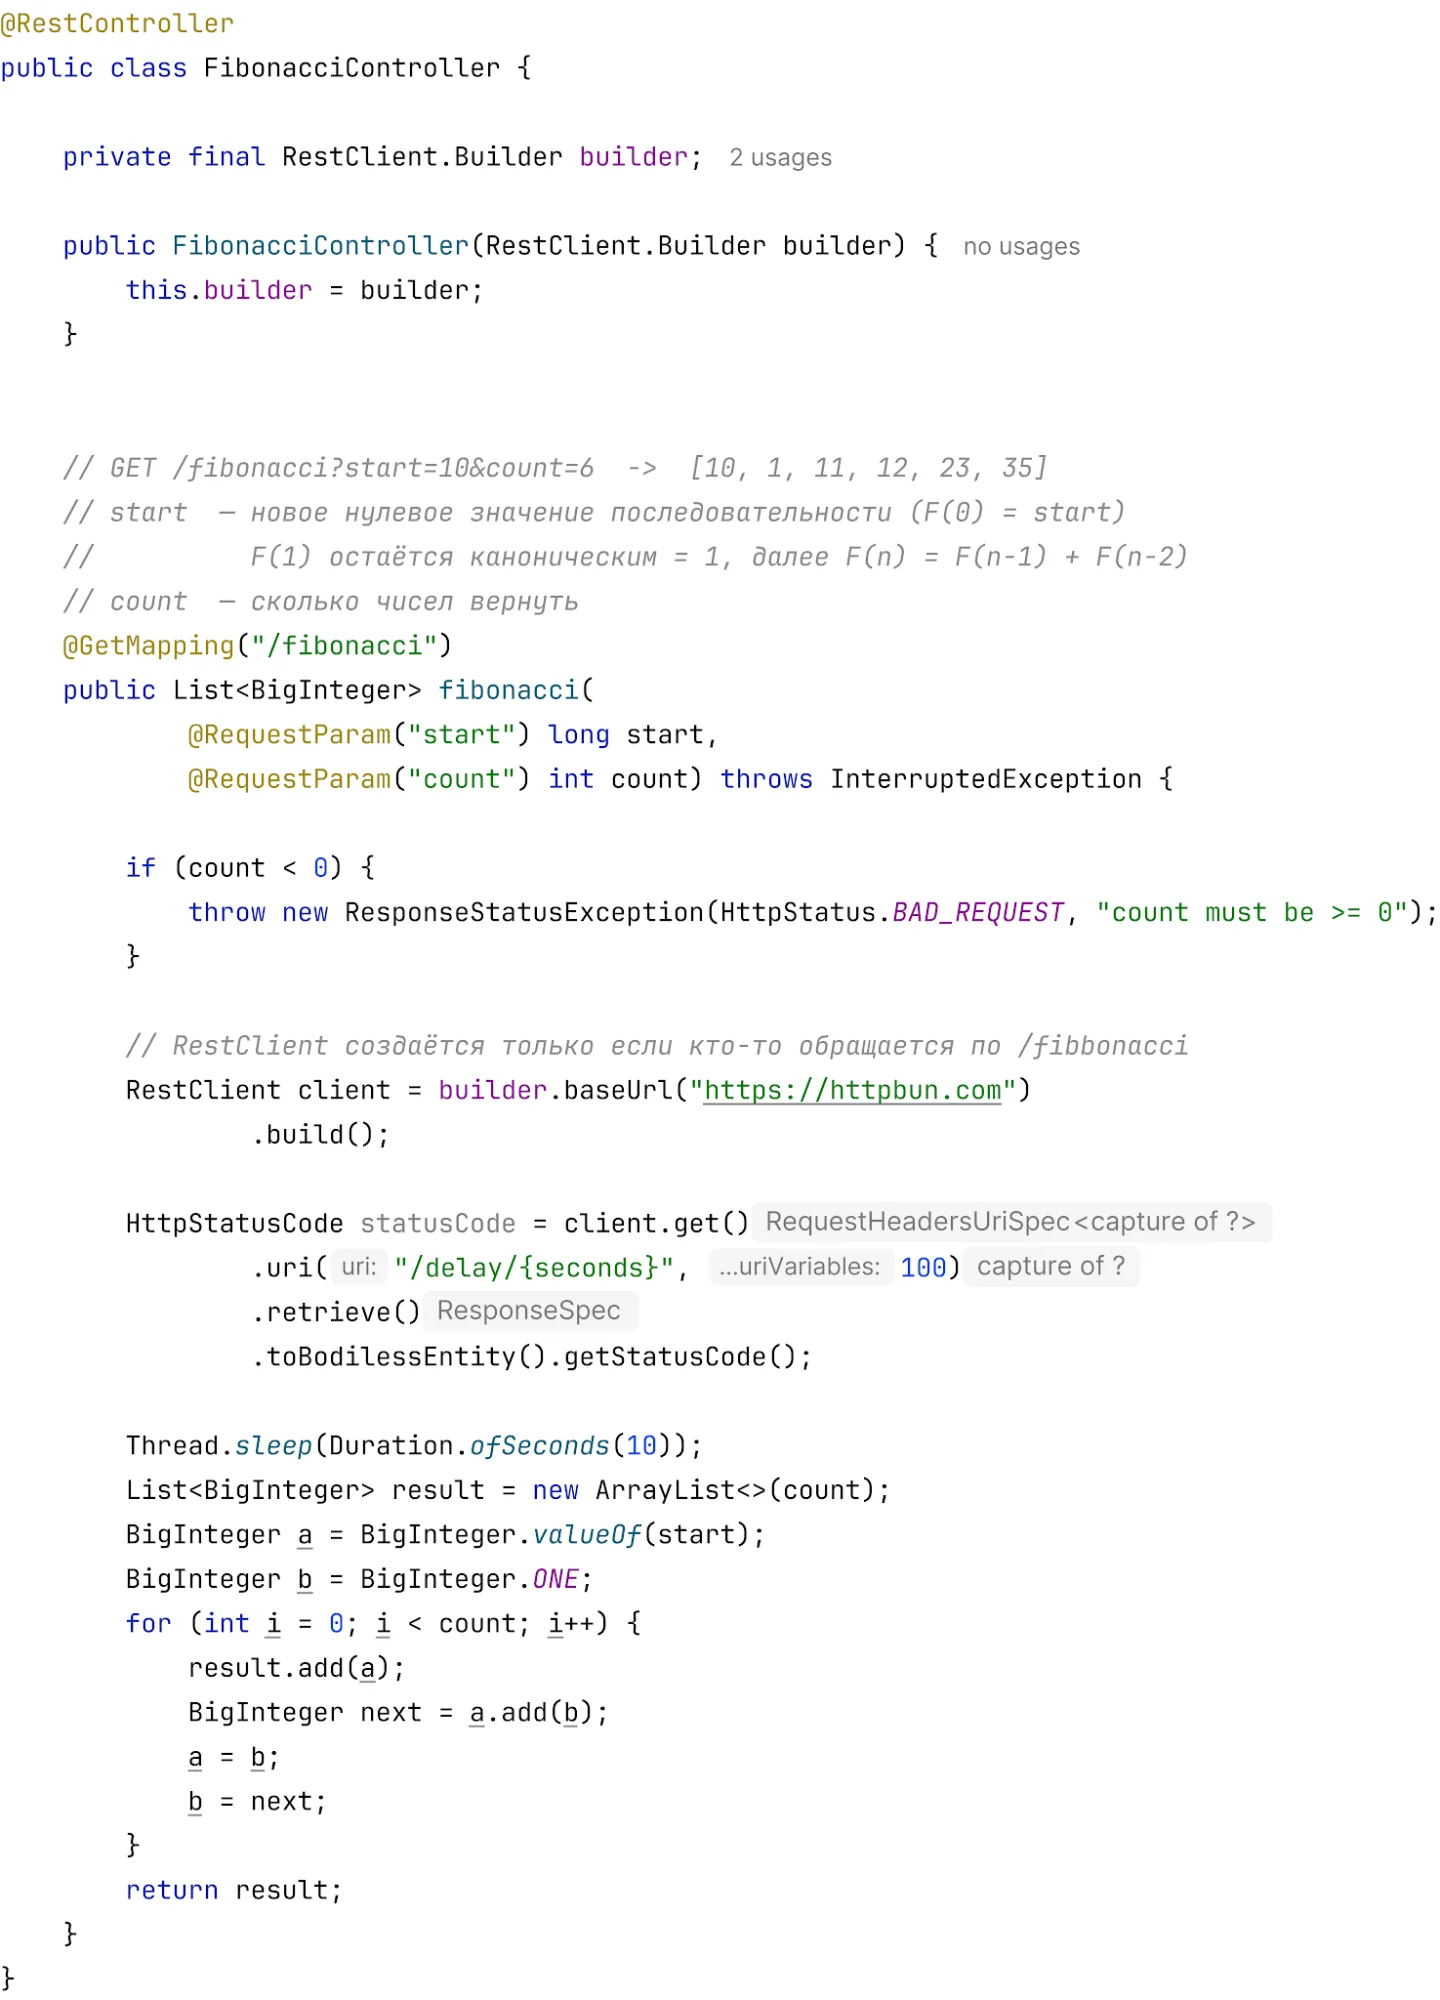
Контроллер из примера: HTTP-запрос к сервису с задержкой внутри обработчика.
| Что происходит | По чему видно в стектрейсе |
|---|---|
| Поток ждёт новый запрос | Короткий стектрейс, упирающийся в очередь задач Tomcat: LinkedBlockingQueue.take, TaskQueue.take, ThreadPoolExecutor.getTask |
| Поток обрабатывает запрос и ждёт ответ по HTTP | В стектрейсе есть метод контроллера (FibonacciController.fibonacci) и код HTTP-клиента Spring, например JdkClientHttpRequest.executeInternal |
Явного ожидания ввода-вывода в стектрейсе не будет: оба потока стоят на Unsafe.park, разница только в том, кто именно их туда привёл. Искать InputStream.read бесполезно — нужны эвристики по конкретным фреймам, как JdkClientHttpRequest.executeInternal в примере выше.
В статье упомянуто, что команда хочет показывать причину ожидания прямо в интерфейсе — не «поток ждёт», а «поток ждёт ответ HTTP-сервиса» или «ждёт базу». Остальные заявленные планы — в списке потоков.
Что дальше
- Потоки и стектрейсы — фильтры, CPU Load, переход из стектрейса в код.
- Графики — как читать CPU, GC Load и Heap Memory.
- Профилировщик Java — когда нужен профиль за интервал, а не снимок.